从构想 to 部署 人工智能应用软件开发全流程指南
引言
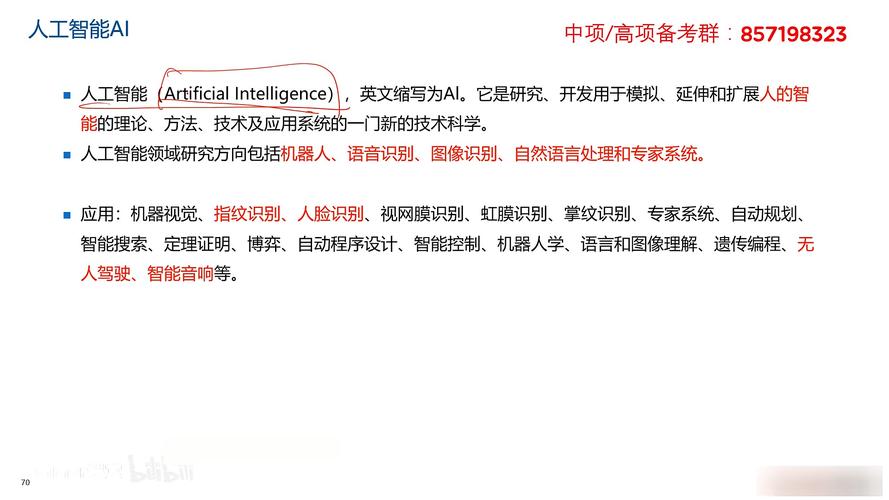
人工智能(AI)正从实验室走向千行百业,将AI能力封装为可交付、可运营的软件产品,是技术落地的关键一跃。与传统软件开发相比,AI应用软件在需求定义、数据工程、模型生命周期管理以及工程化部署等环节均呈现出显著差异。本指南旨在系统梳理人工智能应用软件开发的完整流程与核心实践,帮助团队从零到一构建可靠的智能应用。
一、需求定义与价值验证
AI应用开发的第一步不是写代码,而是明确“解决什么问题”。需避免“为AI而AI”的陷阱,聚焦业务痛点,并评估AI是否是最优解。关键动作包括:
- 场景筛选:优先选择数据基础好、容错率适中、人工成本高的场景(如客服质检、文档审核、预测性维护)。
- 可行性评估:判断问题属于规则驱动还是数据驱动,明确模型性能的验收标准(如准确率、召回率、响应延迟)。
- ROI测算:评估数据标注成本、算力消耗与预期收益,确保项目具备商业可持续性。
二、数据工程:AI应用的基石
数据质量决定模型上限。AI软件的数据工程贯穿需求、开发与运维全过程:
- 数据采集与治理:建立多源数据接入管道,统一数据标准与隐私合规要求。对敏感数据需落实脱敏、加密与访问控制。
- 标注体系设计:明确标注规范、质检流程与一致性指标(如Kappa系数)。建议采用“预标注+人工校验”模式提升效率。
- 数据版本管理:使用DVC或类似工具对数据集进行版本化,确保训练、验证与测试集的可追溯性,避免数据泄漏。
三、模型开发与优化
模型开发并非追求SOTA(State-of-the-Art),而是寻求性能、成本与可维护性的平衡:
- 基线优先:先构建简单模型(如逻辑回归、轻量级预训练模型)作为基线,再逐步迭代复杂模型。
- 实验管理:使用MLflow或Weights & Biases跟踪实验参数、指标与模型产物,确保结果可复现。
- 评估体系:除离线指标外,需构造贴近真实分布的评测集,并关注模型在不同子群体上的公平性与鲁棒性。
四、应用架构与工程化
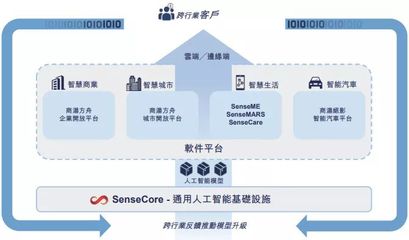
AI应用软件需要将模型能力封装为高可用的服务。典型架构分为三部分:
- 模型服务层:采用Triton Inference Server或TorchServe等工具将模型发布为API,支持批处理与实时推理。关注GPU利用率、自动扩缩容与健康检查。
- 业务逻辑层:将模型输出与规则引擎、知识库结合,处理长尾场景与兜底逻辑。建议采用“模型+规则”混合架构提升可控性。
- 交互层:面向用户的UI/UX需明确AI的局限性,设计恰当的人机协同机制(如低置信度转人工复核)。
API设计原则:接口需定义清晰的请求/响应契约,包含置信度分数与关键中间结果,便于前端进行解释与调试。
五、部署、监控与持续迭代
AI应用的交付上
上不是终点,而是运维的起点:
- 部署模式:根据延迟与隐私要求选择云端API、边缘推理或混合部署。使用CI/CD流水线自动化镜像构建与服务发布。
- 全链路监控:除常规的CPU/内存/延迟指标外,需重点监控数据漂移与概念漂移。建议埋点采集输入特征分布,定期与训练基线比对。
- 反馈闭环:设计用户反馈机制(如点赞/纠错),低置信度样本自动回流至标注队列,形成“数据-模型-应用”的持续改进飞轮。
六、团队协作与工程规范
AI项目需要算法、工程、产品与业务的紧密配合。建议实践包括:
- 接口前置:在模型开发早期即确定服务接口与数据格式,从而Algorithm/Engineering并行开发。
- 代码规范:模型训练代码需工程化管理(如使用pyproject.toml管理依赖),避免“ notebook驱动生产 ”。
- 文档体系:维护模型卡片(Model Sheet),记录用途、局限、训练数据与性能指标,做到责任可追溯。
##
人工智能应用软件开发是一项系统工程,其挑战往往不在于算法本身,而在于数据治理、工程化能力与组织协作。遵循“价值切入-数据先行-工程保障-运营闭环”的路径,借助成熟的MLOps工具链,团队能够有效降低AI应用的落地门槛。最重要的心智是:让AI能力成为产品功能的一部分而非卖点本身——用户关心的是问题是否解决,而非模型有多复杂。
如若转载,请注明出处:http://www.mayuhongkeji.com/product/26.html
更新时间:2026-11-01 00:17:53